MODEL COMPARISON · 2026
Haiku 5.5 vs Luna 6:分数、价格与真实 Demo 对比
Haiku 5.5 vs Luna 6 怎么选?两者基础 API 单价相同,但分数、长提示词计费和实际响应体验并不一样。我们核对官方文档、独立榜单和公开同任务 demo,帮助你按真实用途选择。
- 分数:Haiku 5.5 在 AA Intelligence Index 中领先,43 比 38。
- 价格:双方基础单价都是输入 $0.10、输出 $0.50 / 百万 tokens;下方长提示词示例中,Luna 更便宜。
- 速度:Haiku 输出吞吐量更高;引用的 40 项任务测试中,Luna 完成得更快。
- Demo:下方可以直接看立交桥、游乐场两组实际输出。
Haiku 5.5 vs Luna 6:分数和参数对照
| 指标 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| AA Intelligence Index | 43 · max | 38 · max |
| AA 输出吞吐量 | ≈241 tokens/s | ≈127 tokens/s |
| 上下文窗口 | 1 百万 tokens | 1.05 百万 tokens |
| 标准最大输出 | 128K tokens | 128K tokens |
| 基础输入 / 输出价格,每百万 tokens | $0.10 / $0.50 | $0.10 / $0.50 |
| 长提示词计费门槛 | 超过 100K input tokens | 超过 272K input tokens |
| 长提示词输入 / 输出价格,每百万 tokens | $0.50 / $2.50 | $0.20 / $0.75 |
Artificial Analysis 的 Intelligence Index 当前列出 Haiku 43 分、Luna 38 分,两页均标注 max 配置;输出吞吐量快照也偏向 Haiku。分数来自该机构的测试配置与任务集合,不是正确率,也不能直接换算为“好 5%”。来源:Haiku 榜单、Luna 榜单。
综合分数适合初筛,却不能代替你的实际任务。如果产品主要提取发票、生成 SQL 或写中文营销内容,就应该分别检查这些任务的通过率。平均能力更高的模型,仍可能在最常见的工作上输给另一个模型。先确定验收标准,再决定分数差是否有实际价值。
上下文和输出参数来自 Anthropic 文档 与 OpenAI 文档。百万级上下文代表容量,不保证模型能准确找到长文档里每一个细节。测试长文档时,把重要事实放在开头、中间和末尾,并用原文核验答案。
同任务 demo 截图:两种实际输出
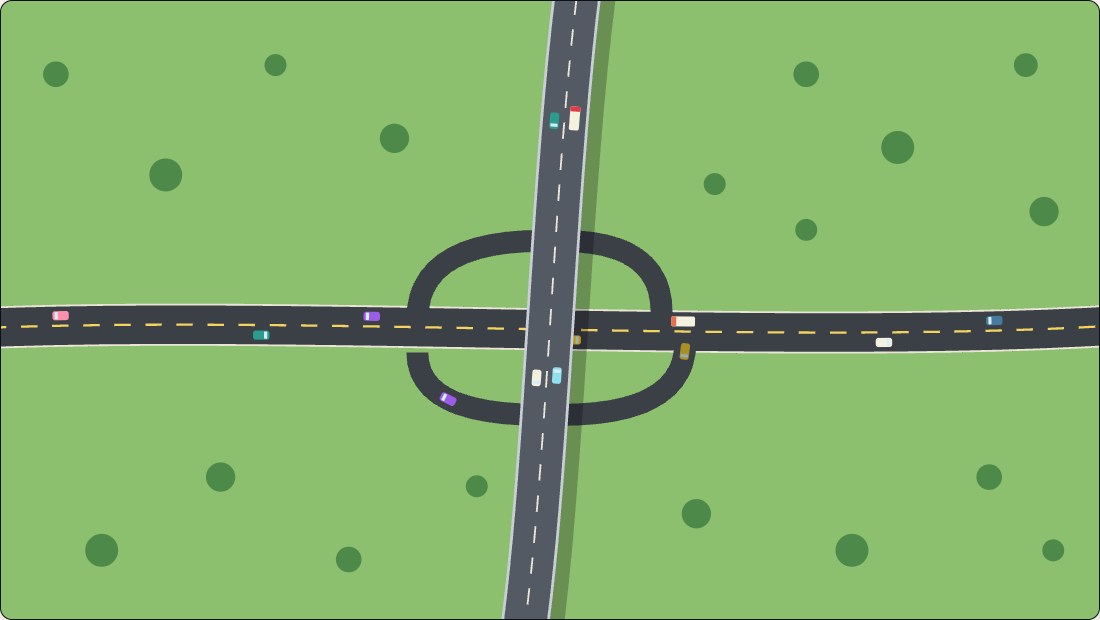
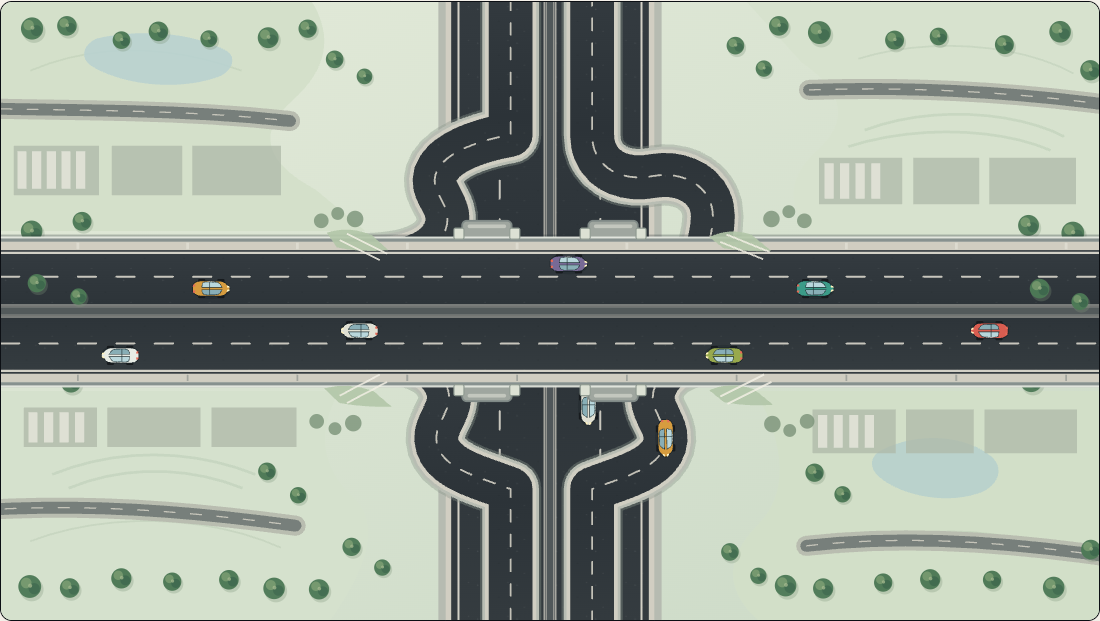
BitsMinds 的三任务对比在 Claude Code 与 Codex 中使用相同任务 brief。以下四图是 10 月 9 日截取的公开渲染结果,并非本站重新跑出的测试。立交桥使用 Haiku xhigh 与 Luna max;游乐场双方均为 max。客户端和努力等级不同,因此不能把所有差异都归因于模型。
立交桥:层级、匝道与车辆
游乐场:摩天轮、旋转木马与倒影
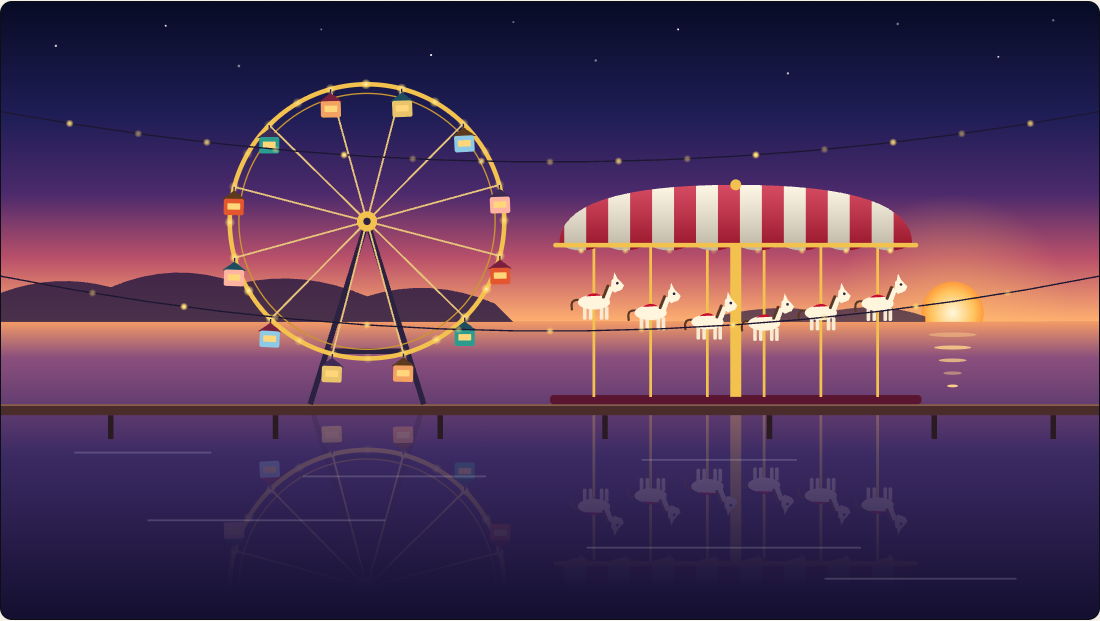
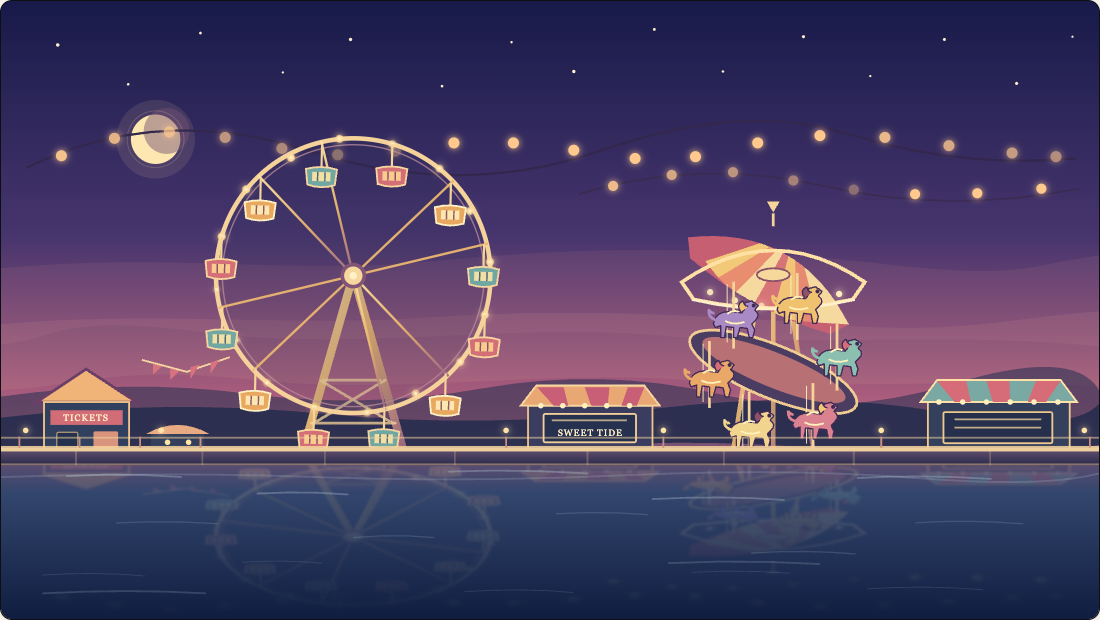
本站对画面的观察:Luna 的立交桥道路细节更多,能清楚看到多车道高架;Haiku 的画面更简洁。两张游乐场画面都包含摩天轮、旋转木马和倒影,但构图不同。这是对静态截图的观察,不是自动评分。点击图片可查看原尺寸。
截图不能证明车辆路径、动画流畅度或完整任务要求全部正确。请打开原文检查动画。漂亮的画面与正确实现行为,需要分别验收。原作者还记录了一个 Haiku 未生成可用结果的火箭任务,因此我们没有为它拼出不存在的双模型截图。
如果你要选择前端开发模型,可以给双方同一组件任务,保存首轮输出,并在桌面与手机尺寸检查。保持素材权限与修复次数一致。多次修改后的漂亮效果,回答的是“最终能做到什么”,首轮结果回答的是“一开始能做到什么”。对上线工作而言,两种成本都值得记录。
更高分数,是否代表回答更可靠?
Kingy AI 的 40 项任务测试对每项任务、每个模型各运行两次。严格规则下,Haiku 通过 60/80 个输出,Luna 通过 51/80;报告的完成时间中位数分别为 6.83 秒和 2.92 秒。这支持该测试中的可靠性与延迟取舍,不足以宣布通用冠军。
这组结果使用特定客户端与默认设置;重复运行不是 80 个互不相关的新任务。严格字数、顺序或格式规则,也可能拒绝语义有用的答案。这对生产解析器可能合理,对开放式写作则未必有代表性。引用通过率之前,先看评分规则与你的场景是否一致。
“Haiku 每秒输出更多”与“Luna 在另一组任务里更早完成”并不矛盾。完整耗时包含排队、输入处理、推理、首 token 延迟和输出长度;吞吐量只覆盖其中一段。聊天应用应记录首段有用内容出现的时间,后台任务则更关注最终完成量和成功率。
API 价格:基础相同,长上下文不同
标准未缓存文本请求的基础单价,双方均为输入 $0.10、输出 $0.50 / 百万 tokens。差异出现在单次提示词跨过长上下文门槛时:Haiku 为 100K,Luna 为 272K。下表按请求所处档位计费,并固定输出数量,便于比较。来源:Haiku 文档、OpenAI 价格表。
| 输入 + 输出 tokens | Haiku 5.5 | Luna 6 |
|---|---|---|
| 10,000 + 2,000 | $0.002 | $0.002 |
| 150,000 + 2,000 | $0.080 | $0.016 |
| 300,000 + 2,000 | $0.155 | $0.0615 |
公式为:输入 tokens × 输入单价 / 1,000,000 + 输出 tokens × 输出单价 / 1,000,000。这些是算术示例,不是实测账单,也没有假设相同文档在两家一定得到相同 token 数。缓存、批处理、工具、税费和额外可计费推理 tokens 未包含在内。预算应以真实请求返回的 usage 为基础。
150K 输入的例子很适合长文档工作:它已经超过 Haiku 门槛,但还没超过 Luna 门槛。300K 时双方都进入长上下文档位。一个月累计一百万 tokens 的短请求,不会自动变成一条长提示词。应先按每次请求长度确定费率,再汇总账单。
采购时,更有意义的指标是“每个通过验收的结果花多少钱”。便宜的首轮答案如果需要重试、修复与人工检查,最终成本可能更高。请同时记录失败率、重试次数和计费量;在质量都合格时,提示词长度可能比基础单价更能左右选择。
按用途选择:哪个更适合你?
- 短文本与结构化提取:在基础费率下同时测试,分别统计格式有效性、事实准确性和指令遵循。
- 长文档:统计单次提示词长度分布,Luna 更高的计费门槛可能显著改变账单。
- 前端编程:从截图挑选测试题,再检查代码、动画、响应式布局与可访问性。
- 交互助手:在真实并发量与努力等级下测首段有效响应和完整完成时间。
- 内容写作:盲评信息价值、来源、语气,以及需要人工修改的程度。
与其继续收集排名,不如从真实工作里挑二十项代表任务。先去除敏感信息,再写好成功标准。既要覆盖简单日常任务,也要有少量困难案例和曾经造成生产错误的问题。保持输出预算、工具权限和重试政策一致。
保存模型标识、日期、设置、usage 和输出。条件允许时,不让评审知道答案来自哪个模型。把通过率、每个合格结果的成本和延迟放在一起看。如果差异很小,就按接入成本、额度可用性和团队能处理的失败模式选择;版本、价格或业务变化后再复测。
Haiku 5.5 vs Luna 6 常见问题
Luna 6 就是 GPT-6 Luna 吗?
本文使用“Luna 6”作为搜索简称,实际比较对象是 Claude Haiku 5.5 与 OpenAI GPT-6 Luna。调用 API 时,请使用官方文档中的准确模型标识,不要混用其他 Haiku 或 GPT-6 版本。
哪个分数更高?
目前 AA Intelligence Index 快照中,max 配置的 Haiku 为 43,Luna 为 38。这个综合结果不保证 Haiku 在每类任务中获胜。
哪个更便宜?
基础文本单价相同。上面的固定 token 长提示词例子中,Luna 更便宜,因为门槛与高档费率不同。实际成本还取决于分词、输出、推理、重试和折扣。
哪个更快?
AA 快照中的输出吞吐量偏向 Haiku,另一组 40 任务测试中的完成时间偏向 Luna。请在自己的客户端和努力等级下测完整请求。
哪个更适合代码和视觉 demo?
公开案例显示两者输出有明显差异,但少数视觉任务不能证明通用编程能力。除了外观,也要检查编译、行为、可访问性与维护成本;有项目测试时应运行测试。
截图能证明某个模型永远更好吗?
不能。它们记录特定设置下的公开输出,帮助你理解案例,但不能代替完整提示词、重复测试和运行时验证。